Впервые перцептрон был испытан с помощью компьютерной симуляции, написанной на языке программирования SHARE и запущенной в 1957 году на IBM 704, одной из первых коммерческих центральных ЭВМ. На самых ранних этапах в ЭВМ вводили серию перфокарт и после пятидесяти попыток она, видимо, «научилась отличать карты, помеченные слева, от карт, помеченных справа»[487]. Розенблатт считал это доказательством того, что более сложная архитектура перцептрона позволит распознать более сложные образы. Вскоре после статьи в New York Times идея стала принимать форму громоздкого оборудования, работа над которым закончилась только в 1960 году. Это был легендарный перцептрон Mark I (сейчас находится в Смитсоновском музее в Вашингтоне, округ Колумбия; см. рис. 9.3). Mark I – та цифровая ЭВМ, которую Джон фон Нейман использовал в 1940‑х годах для расчетов Манхэттенского проекта.
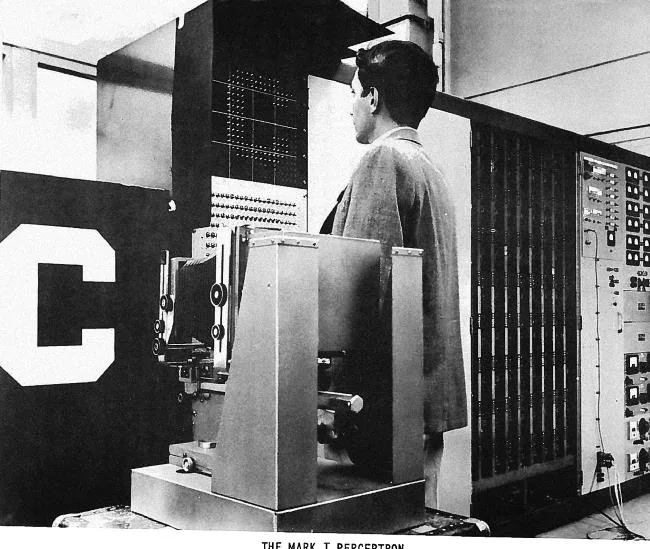
Рис. 9.3 Перцептрон Mark I (Rosenblatt F. Principles of Neurodynamics: Perceptrons and the Theory of Brain Mechanisms. Buffalo, NY: Cornell Aeronautical Laboratory, 1961. P. III)
Ее расширили аналоговым модулем перцептрона. Работая в тысячу раз медленнее IBM 704, аппаратно-программный гибрид Mark I позволял программисту перемонтировать сеть вручную, что было быстрее, чем переписывать программу. В руководстве по эксплуатации это описано так:
Перцептрон Mark I представляет собой устройство для обучения и распознавания образов. Оно учится классифицировать плоские образы в группы на основе определенных геометрических сходств и различий. К свойствам, которые устройство использует для различения и обобщения, относятся положение на сетчатке поля зрения, геометрическая форма, частота встречаемости и размер. Если из множества возможных оснований для классификации требуется какое-то конкретное, его можно передать перцептрону с помощью сессии принудительного обучения, или исправления ошибок. Если предоставить перцептрон самому себе, он все равно сможет разделить представленные образы на классы, пользуясь самостоятельно сформированным критерием классификации. Процесс формирования таких критериев называется спонтанным обучением[488].
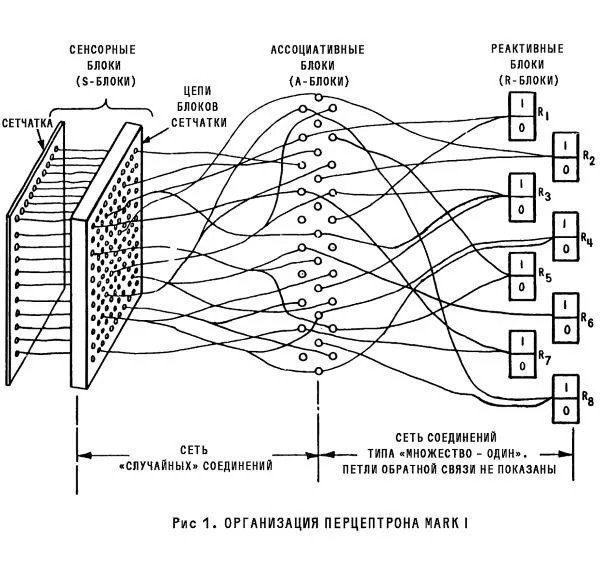
Рис. 9.4. Схема организации перцептрона Mark 1 (Rosenblatt F. Mark I Perceptron Operators’ Manual. Buffalo, NY: Cornell Aeronautical Laboratory, 1960)
Перцептрон Mark I представлял собой простую нейронную сеть, состоящую из трех слоев блоков, которые последовательно соединялись: «сенсорные, или S-блоки, ассоциативные, или A-блоки, реактивные, или R-блоки» (см. рис. 9.4)[489]. Входной слой («сетчатка») представлял собой камеру размером 20 x 20 пикселей с 400 фоторецепторами. Эти сенсорные блоки, которым назначались фиксированные веса, случайно или топологически связывались со слоем из 512 ассоциативных блоков[490]. Ассоциативные блоки в свою очередь связывались с восемью реактивными блоками (R-блоками, или выходом), веса которых автоматически регулировались («веса» назначались аналоговыми потенциометрами, также доступными к ручной регулировке). Подобно искусственным нейронам Уоррена Мак-Каллока и Уолтера Питтса, ассоциативные и реактивные блоки действовали по логике порогового значения: они суммировали входные значения и срабатывали, только если сумма превышала заданный порог (см. рис. 9.5)[491]. В руководстве по эксплуатации процесс описывался как своеобразная реализация правила Хебба, но, возможно, это слишком вольное толкование:
А-блоки отличаются от других блоков тем, что при активации значение возбуждения, которое они передают R-единицам, зависит от сравнительного успеха, достигнутого конкретным А-блоком в переключении соответствующей R-единицы в прошлом. Эти значения формируют память перцептрона[492].
Из этого запутанного клубка проводов стоит вынести, что обучаемые параметры суть потенциометры, которые связывают А-блоки с Р-блоками. 512 х 8 = 4096 параметров. Если быть точным, перцептрон Mark 1 запускал параллельно восемь простых перцептронов, каждый из которых предназначался для распознавания определенного шаблона. При сетчатке размером 20 х 20 пикселей каждый простой перцептрон имел 400 параметров. В любом случае, с точки зрения алгоритмической сложности для ресурсов того времени речь шла о большом количестве переменных, которые требовалось вычислять методом пошаговой аппроксимации. В качестве сравнения с другим масштабом сложности: для запуска алгоритма перцептрона современному настольному компьютеру хватит трех строчек кода на Python, а такая большая модель, как GPT, насчитывает триллион параметров (поэтому для ее обучения и развертывания нужен большой центр обработки данных).
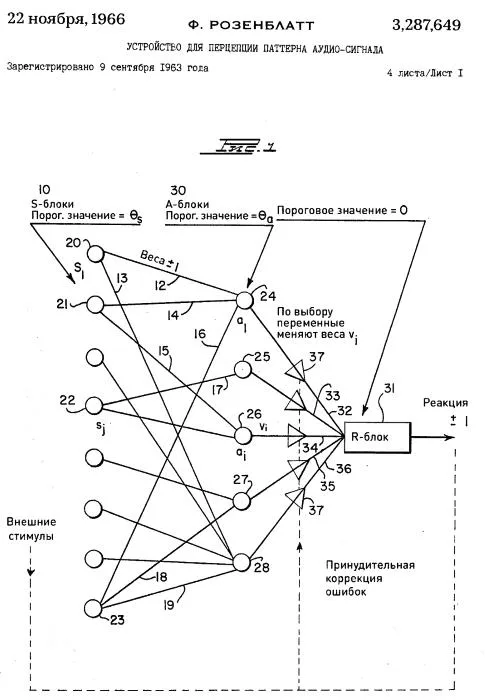
Рис. 9.5 В 1963 году Розенблатт подал в заявке на патент US3287649A эскиз простого перцептрона. Патент был получен в 1966-м и истек через двадцать лет в 1983 году
Случайность исходных связей и весов была критически важна для Розенблатта, который хотел показать, что перцептрон проявляет способность к самоорганизации, даже если запускается из неупорядоченного состояния. Ученый был воодушевлен вычислительным разрешением перцептрона: «Ясно, что при удивительно малом числе единиц – по сравнению с 1010 нервных клеток в человеческом мозге, – перцептрон способен к очень сложной деятельности»[493]. Архитектура перцептрона может варьироваться и принимать различные конфигурации, увеличивая число слоев и функций. Уже по статьям Розенблатта было понятно, что угадывание оптимальной конфигурации вычислительной сети становится самостоятельным ремеслом и частью экспериментальной практики.
Угадать хорошую архитектуру перцептрона – ползадачи; вторая половина заключается в том, чтобы разработать алгоритм обучения и метода исправления ошибок, которые позволят найти оптимальное значение параметров, заданных сетевыми соединениями[494]. Процедура обучения основывалась на предположении, что если задача классификации в принципе решаема (множество изображений можно линейно разделить на две группы), то параметры придут к оптимальным значениям за конечное число шагов. Основным алгоритмом обучения перцептрона служит процедура пошаговой аппроксимации, которая по сути представляет собой автоматизированную версию дифференциального исчисления:
1. Возьмите обучающий набор данных, запустите перцептрон со случайными весами.
2. Вычислите выход перцептрона для входных данных примера из обучающего набора.
3. Если выход перцептрона не соответствует правильному для этого примера выходу:
a. Если на выходе 1, а должно быть 0, уменьшите веса с входом 1.
b. Если на выходе 0, а должно быть 1, увеличьте веса с входом 1.
4. Перейдите к следующему в обучающем наборе примеру и повторяйте шаги 2–4, пока перцептрон не перестанет ошибаться[495].
Современное глубокое обучение использует более совершенные алгоритмы (например, градиентный спуск), но принцип проб и ошибок остается прежним:
– представить нейронной сети изображение;
– проверить правильность вывода;
– если результат неправильный, немного увеличить или уменьшить значение параметров;
– повторять процедуру до тех пор, пока нейронная сеть не вычислит правильный результат.
Необходимо найти самую эффективную процедуру, которая приводит к конечному результату за наименьшее количество шагов. Дизайн алгоритма обучения – еще один уровень абстракции и решения задач, отличный от структуры нейронной сети. С этой точки зрения то, что многие до сих пор называют «искусственным интеллектом», представляет собой лишь метод математической оптимизации. Это все еще случай аппроксимации грубой силой, и логика такой аппроксимации в больших моделях с триллионами параметров стала еще «грубее». Как бы то ни было, показательно, что в основе самых передовых методов «искусственного интеллекта» лежат те же процедуры аппроксимации, что и в основе расчетов со времен Античности (см. главу 1).
Что умел перцептрон Mark 1? С точки зрения распознавания образов – не очень многое. Он мог отличить черный квадрат в левой стороне поля зрения от квадрата в правой стороне и различать простые буквы, если они выровнены по центру визуальной матрицы 20 x 20. Как продемонстрировали Марвин Минский и Сеймур Пейперт в рамках знаменитой критики, способность устройства распознавать образы была примитивной и ограничивалась непрерывными фигурами. Розенблатт и его команда знали об этих ограничениях, но полагали, что архитектуры с бóльшим числом слоев смогут решать более сложные задачи по распознаванию (их правоту в конечном итоге доказало глубокое обучение):
Представляется разумным ожидать, что подобная перцептрону машина с логической глубиной 3 и более (с двумя и более слоями А-блоков, обеспечивающих последовательное возбуждение) окажется мощнее, чем перцептрон[496].
Следует отметить, что уже в 1958 году Розенблатт предвидел появление пространственных ограничений (похожи на фильтры), ставших основой идеи сверточных нейронных сетей, из которой возникло глубокое обучение[497]. В частности, в «Принципах нейродинамики» он упоминал проведенное Дэвидом Хьюбелем и Торстеном Визелем исследование коры головного мозга кошек и сформулированные этими учеными топологические ограничения, которые повлияли на создание нейронной сети «неокогнитрон» Кунихико Фукушимы (1980), архитектуру Яна Лекуна LeNet (1989) и, наконец, AlexNet (2012)[498].
Розенблатт также понимал, что статистические нейронные сети логически ограничены в имитации человеческого интеллекта: «Только лишь статистическая разделимость не дает достаточного основания для более высокого уровня абстракции. Для таких целей требуется некоторая более мощная система, чем перцептрон»[499]. На сегодняшний день из-за отсутствия полной теории статистического обучения искусственные нейронные сети и глубокое обучение остаются на эпистемологической стадии эксперимента. Иными словами, это машины, чьи возможности неизвестны, а ошибки непредсказуемы.