7.3. Всемирная паутина
Всемирная паутина (World Wide Web), или просто «веб», — это архитектура, которая является основой для доступа к соединенному ссылками контенту на миллионах компьютеров по всему интернету. За 10 лет своего существования из средства координации разработки экспериментов по физике высоких энергий в Швейцарии она превратилась в то, что миллионы людей с разными интересами теперь называют интернетом. Невероятная популярность Всемирной паутины связана с тем, что она проста в использовании даже для новичка. Кроме того, при помощи многофункционального графического интерфейса она предоставляет доступ к гигантскому количеству информации практически по любому вопросу, от африканских муравьедов до яшмового фарфора.
Всемирная паутина была создана в 1989 году в Европейской организации по ядерным исследованиям ЦЕРН (Conseil Européen pour la Recherche Nucléaire, CERN) в Швейцарии. Изначальная цель заключалась в том, чтобы наладить совместную работу больших групп, участники которых были разбросаны по разным странам и часовым поясам. Исследователям требовался доступ к постоянно меняющимся отчетам, чертежам, рисункам, фотографиям и другим документам, появляющимся по ходу ведения экспериментов в области физики элементарных частиц. Предложение создать паутину из связанных друг с другом документов пришло от физика ЦЕРН Тима Бернерса-Ли (Tim Berners-Lee). Первый (текстовый) прототип был готов к эксплуатации 18 месяцев спустя. Публичная демонстрация, произведенная в декабре 1991 года на конференции Hypertext’91 в Сан-Антонио, штат Техас, привлекла внимание ряда других ученых, в результате чего Марк Андриссен (Marc Andreessen) из Иллинойсского университета начал разработку первого графического браузера — Mosaic. Программа увидела свет в феврале 1993 года.
Остальное, как говорится, уже история. Браузер Mosaic стал настолько популярным, что год спустя Марк Андриссен решил основать собственную компанию Netscape Communications Corp.. Компания занималась разработкой программного обеспечения для Всемирной паутины. В течение последующих трех лет между Netscape Navigator и Internet Explorer от Microsoft развернулась настоящая «война браузеров». Разработчики с обеих сторон пытались захватить новый рынок, лихорадочно добавляя в свои программы как можно больше функций (а заодно и ошибок), чтобы превзойти соперника.
На протяжении 1990-х и 2000-х годов объем веб-контента рос в геометрической прогрессии, пока число веб-сайтов не достигло миллионов, а число веб-страниц — миллиардов. Некоторые из них стали невероятно популярными. Эти сайты и стоящие за ними компании сегодня в значительной мере определяют ландшафт современного интернета. В их числе книжный магазин Amazon (1994), торговая площадка eBay (1995), поисковая система Google (1998) и социальная сеть Facebook (2004). Период в 2000-х, когда стоимость многих веб-компаний могла взлететь до сотен миллионов долларов за одну ночь, только чтобы обрушиться практически на следующий день (когда оказывалось, что их создание было просто пиар-ходом), даже имеет название — «эра доткомов» (dot com era). Новые идеи в Сети и сейчас могут мгновенно озолотить своих авторов. Многие из них исходят от студентов. Например, Марк Цукерберг (Mark Zuckerberg) был студентом Гарварда, когда придумал и запустил проект Facebook, а Сергей Брин (Sergey Brin) и Ларри Пейдж (Larry Page) учились в Стэнфорде, когда основали Google. Возможно, вы будете следующим.
В 1994 году ЦЕРН и Массачусетский технологический институт (Massachusetts Institute of Technologies, MIT) подписали соглашение об основании Консорциума Всемирной паутины (World Wide Web Consortium, W3C). Цель этой организации — дальнейшее развитие Всемирной паутины, стандартизация протоколов и поощрение взаимодействия между отдельными сайтами. Директором консорциума стал Бернерс-Ли. С тех пор к нему присоединились несколько сотен университетов и компаний. Хотя о Всемирной паутине написано уже очень много книг, получить самую свежую информацию о ней проще всего на официальном сайте. Домашняя страница W3C находится по адресу http://www.w3.org. Здесь заинтересованный читатель найдет ссылки на другие страницы, содержащие информацию обо всех документах консорциума и о его деятельности.
7.3.1. Представление об архитектуре
С точки зрения пользователя, Всемирная паутина состоит из огромного количества контента в виде веб-страниц (Web pages). На каждой странице обычно есть ссылки на сотни других объектов, которые могут размещаться на веб-сервере в любой точке мира. Раньше такой объект мог быть еще одним текстом или картинкой, а в настоящее время, помимо этого, существует широкий спектр других объектов, таких как рекламные объявления и скрипты отслеживания. Веб-страница также может содержать ссылки (links) на другие страницы, на которые можно перейти, кликнув по такой ссылке. Этот процесс можно повторять бесконечно. Идея использования страниц, направляющих друг на друга, — так называемого гипертекста (hypertext) — была впервые предложена в 1945 году Ванневаром Бушем (Vannevar Bush), профессором электротехники Массачусетского технологического института. Это было задолго до возникновения интернета и даже до появления коммерческих компьютеров. (Хотя в некоторых университетах уже были созданы первые грубые прототипы, которые занимали целые помещения и потребляли уйму энергии (сравнимо с небольшим заводом), обладая при этом вычислительной мощностью в миллионы раз меньшей, чем современные умные часы.)
Для просмотра страниц обычно используется специальная программа, называемая браузером (browser). Примерами популярных браузеров могут служить Brave, Chrome, Edge, Firefox, Opera и Safari. Браузер предоставляет пользователю запрашиваемую страницу, интерпретирует ее контент и выводит должным образом отформатированные страницы на экран. Контент может представлять собой сочетание текста, изображений и команд форматирования и выглядеть как обычный документ, видео или программа с графическим интерфейсом.
Пример веб-страницы с большим количеством объектов приведен на илл. 7.19. Это страница сайта Федеральной комиссии по связи США. Она содержит некий текст и графические элементы (большая часть которых является нечитаемой из-за небольших размеров иллюстрации). Многие элементы содержат ссылки на другие страницы. Загружаемая браузером индексная страница (index page) обычно содержит указания для браузера относительно того, где находятся другие необходимые объекты, и того, каким образом и в какой части страницы их нужно отобразить.
Илл. 7.19. Загрузка и отображение веб-страницы требует ряда HTTP/HTTPS-запросов к нескольким серверам
Строки текста, иконки, изображения и прочие элементы, представляющие собой ссылки на другие страницы, называются гиперссылками (hyperlinks). Чтобы перейти по ссылке, пользователь стационарного компьютера или ноутбука должен навести указатель мыши на область страницы с гиперссылкой (что приведет к изменению формы указателя) и выполнить щелчок. Пользователю смартфона или планшета потребуется коснуться ссылки. Выполняя переход по ссылке, мы просто сообщаем браузеру, что он должен загрузить другую страницу. На заре Всемирной паутины ссылки выделялись подчеркиванием и другим цветом, чтобы их можно было отличить от остального текста. Сегодня создатели веб-страниц используют таблицы стилей (style sheets), позволяющие управлять внешним видом многих элементов страницы, включая гиперссылки, так что они могут выглядеть как того пожелает дизайнер сайта. Их внешний вид даже может меняться динамически, при наведении указателя мыши. Задача визуального выделения ссылок для обеспечения удобной навигации по сайту лежит на его создателях.
Заинтересовавшись определенной статьей, посетитель страницы может кликнуть по нужной области, чтобы браузер загрузил и отобразил новую страницу. При этом на первой странице могут быть ссылки на десятки других страниц. Каждая из них может содержать контент, размещенный на том же компьютере, что и первая страница, либо на компьютерах в другой части мира. Для пользователя это не заметно. Как правило, браузер загружает любые объекты, к которым привязаны ссылки, выбираемые пользователем, обеспечивая свободное перемещение между устройствами в ходе просмотра контента.
Браузер отображает веб-страницу на клиентском компьютере, отсылая запрос на один или несколько серверов, которые отвечают, передавая контент страницы. Запросно-ответный протокол для отображения страниц представляет собой простейший текстовый протокол, работающий поверх TCP (подобно SMTP), — HTTP. Его защищенная версия HTTPS является основным способом доставки контента в современном интернете. В качестве контента может выступать простой документ, который считывается с диска, или результат работы программы или запроса, отправленного в базу данных. Страница называется статичной (static page), если это документ, который всегда отображается одинаково. Если же она создается по требованию программы или сама содержит какую-либо программу, то это динамическая страница (dynamic page).
Контент динамической страницы может быть разным при каждом вызове. К примеру, главная страница интернет-магазина может различаться для каждого посетителя. Если клиент книжного магазина в прошлом покупал детективы, на главной странице он, скорее всего, увидит новые книги этого жанра, а человек, интересующийся рецептами, обнаружит на ней новые кулинарные книги. Мы вскоре расскажем, как веб-сайты следят за тем, что нравится покупателям. Если кратко, это обеспечивается с помощью файлов cookie.
Для загрузки веб-страницы браузер связывается с рядом серверов. Контент индексной страницы может быть загружен непосредственно из файлов, размещенных в домене fcc.gov. Дополнительный контент, например встроенное видео, может размещаться на отдельном сервере (по-прежнему в домене fcc.gov, но, возможно, на инфраструктуре, предназначенной для хранения такого контента). Индексная страница также может содержать ссылки на другие объекты, например невидимые пользователю скрипты отслеживания или размещенные на сторонних серверах рекламные объявления. Браузер загружает все эти объекты, скрипты и т.д. и собирает их для пользователя в виде единого представления страницы.
Представление страницы предполагает обработку, тип которой зависит от контента. Кроме отображения текста и графических элементов, может понадобиться воспроизвести видеофайл или запустить скрипт, в котором прописан отдельный пользовательский интерфейс, являющийся частью страницы. В нашем случае сервер fcc.gov предоставляет главную страницу, fonts.gstatic.com — дополнительные объекты (к примеру, шрифты), а google-analytics.com — невидимую пользователю аналитику посещаемости сайта. Использование трекеров и обеспечение конфиденциальности в интернете мы обсудим чуть позже в этой главе.
Сторона клиента
Теперь мы подробнее рассмотрим весь процесс со стороны веб-браузера (см. илл. 7.19). По сути, браузер — это программа, которая отображает веб-страницу и реагирует на пользовательские запросы «перехода» к ее элементам. При выборе элемента браузер переходит по гиперссылке и извлекает объект, на который указал пользователь (с помощью щелчка мыши или нажатия на ссылку на экране мобильного устройства).
Как только была создана Всемирная паутина, сразу стало очевидным, что наличие ссылок с одних страниц на другие требует создания механизма именования и расположения страниц. Рассмотрим три самых важных вопроса, на которые нужно ответить, прежде чем отобразить выбранную страницу:
1. Как называется страница?
2. Где она расположена?
3. Как получить доступ к ней?
Если бы каждой странице было приписано уникальное имя, не было бы никакой неоднозначности в их идентификации. Но это не решило бы проблему. Проведем параллель между страницами и людьми. В США практически у каждого взрослого гражданина есть номер социального страхования, который может служить уникальным идентификатором, ведь два разных человека не могут иметь одинаковый номер. Однако если у вас есть только номер социального страхования, вы не сможете выяснить адрес его владельца и уж тем более определить, на каком языке к нему следует обращаться: на английском, испанском или китайском. Во Всемирной паутине возникают примерно те же проблемы.
Найденный способ идентификации страниц решил все три проблемы. Каждой странице приписывается унифицированный указатель ресурса (Uniform Resource Locator, URL), который представляет собой своего рода «имя» страницы во Всемирной паутине. URL-адрес содержит три элемента: протокол (который также называют схемой — scheme), DNS-имя устройства, на котором расположена страница, и уникальный для каждой страницы путь (файл для чтения или программу для запуска на компьютере). В общем случае у пути есть иерархическое имя, которое моделирует структуру каталогов файлов. При этом интерпретация пути — это работа сервера; действительная структура каталогов может и не отображаться.
В качестве примера возьмем URL-адрес страницы на илл. 7.19:
https://fcc.gov/
Этот URL-адрес включает в себя три элемента: протокол (https), DNS-имя хоста (fcc.gov) и имя пути (/), которое веб-сервер часто воспринимает как некоторый индексный объект по умолчанию.
Когда пользователь выбирает гиперссылку, браузер выполняет ряд действий для загрузки той страницы, на которую она указывает. Рассмотрим последовательность действий при активации ссылки в нашем примере:
1. Браузер определяет URL-адрес (исходя из того, какой элемент страницы выбрал пользователь).
2. Браузер запрашивает у службы DNS IP-адрес сервера fcc.gov.
3. DNS выдает в качестве ответа адрес 23.1.55.196.
4. Браузер устанавливает TCP-соединение с этим IP-адресом; поскольку при этом применяется HTTPS, защищенная версия HTTP, TCP-соединение по умолчанию устанавливается с портом 443 (а не со стандартным портом 80 протокола HTTP, который сегодня используется все реже).
5. Браузер отправляет HTTPS-запрос на получение страницы //, которую веб-сервер обычно интерпретирует как некую индексную страницу (например, index.html, index.php и т.п., как указано в конфигурации веб-сервера хоста fcc.gov).
6. Сервер отправляет страницу как HTTPS-ответ, например, в виде файла /index.html, если таковой определен как индексный объект по умолчанию.
7. Если страница содержит URL-адреса, которые нужно отобразить, то браузер получает их таким же способом. В нашем случае эти URL-адреса содержат ряд встроенных изображений, также загружаемых с данного сервера, встроенные объекты с сайта gstatic.com и скрипт с сайта google-analytics.com (а также с ряда других доменов, которые здесь не показаны).
8. Браузер отображает страницу /index.html в том виде, в каком она представлена на илл. 7.19.
9. Если в течение некоторого времени на те же серверы не поступает других запросов, TCP-соединения обрываются.
Многие браузеры отображают текущее выполняемое ими действие в строке состояния внизу экрана. Это позволяет пользователю понять причину низкой производительности: например, не отвечает служба DNS или сервер либо просто сеть сильно перегружается при передаче страницы.
Получить более детальное представление о выполнении веб-страницы можно с помощью так называемой каскадной диаграммы (waterfall diagram) (илл. 7.20).
Каскадная диаграмма показывает список всех объектов, отображаемых браузером в ходе загрузки страницы (в данном случае имеется 64 объекта, но многие страницы содержат сотни объектов), временные зависимости, связанные с загрузкой каждого запроса, и операции, связанные с загрузкой каждой страницы (включая DNS-поиск, установление TCP-соединения, непосредственное скачивание контента и т.д.). Такая диаграмма может многое рассказать о поведении браузера. Например, сколько параллельных соединений он устанавливает с тем или иным сервером и используются ли они повторно; какая часть времени тратится на DNS-поиск, а какая — на непосредственную загрузку объектов. С помощью каскадной диаграммы можно определить и другие потенциальные узкие места производительности.
На URL-адреса не накладывается никаких ограничений по использованию браузером различных протоколов для извлечения разных видов ресурсов. На самом деле для других протоколов был определен ряд дополнительных видов URL-адресов. Наиболее распространенные из них представлены на илл. 7.21 в слегка упрощенном виде.
Кратко пройдемся по этому списку. Протокол http — «родной язык» Всемирной паутины, на котором «разговаривают» веб-серверы. Мы подробно рассмотрим его в этом разделе, уделяя особое внимание его защищенной версии HTTPS. Сегодня она чаще всего используется для доставки объектов в интернете.
Протокол ftp применяется для доступа к FTP-файлам. FTP появился еще до Всемирной паутины и используется уже более четырех десятилетий. Интернет позволяет легко получать файлы, расположенные на различных FTP-серверах по всему миру, предоставляя простой интерактивный интерфейс вместо традиционного интерфейса командной строки. Упрощенный доступ к информации — одна из причин поразительного роста интернета.
Илл. 7.20. Каскадная диаграмма для сайта fcc.gov
Получить доступ к локальному файлу как к веб-странице можно, используя протокол file или просто написав его имя. Для применения этого способа не нужен сервер. Конечно, это работает только для локальных файлов, но не для удаленных.
Протокол mailto не загружает веб-страницы, но зато позволяет отправлять почту через браузер. Когда пользователь переходит по ссылке mailto, большинство браузеров запускает пользовательского агента, предоставляющего форму для написания электронного письма с уже заполненным полем адреса.
Имя
Назначение
Пример
http
Гипертекст (HTML)
https://www.ee.uwa.edu/~rob/
https
Гипертекст с обеспечением безопасности
https://www.bank.com/accounts/
ftp
FTP
ftp://ftp.cs.vu.nl/pub/minix/README
file
Локальный файл
file:///usr/nathan/prog.c
mailto
Отправка почты
mailto:JohnUser@acm.org
rtsp
Потоковая передача мультимедиа
rtsp://youtube.com/montypython.mpg
sip
Мультимедийные вызовы
sip:eve@adversary.com
about
Информация браузера
about:plugins
Илл. 7.21. Некоторые стандартные схемы URL
Протоколы rtsp и sip предназначены для установления сеансов передачи мультимедийных потоков, а также аудио- и видеозвонков.
Наконец, протокол about предоставляет информацию о браузере. Например, если вы пройдете по ссылке about:plugins, большинство браузеров отобразит страницу со списком MIME-типов, обрабатываемых ими с помощью расширений браузера (плагинов). Многие браузеры предоставляют в разделе about: очень интересные сведения. Так, в браузере Firefox по ссылке about:telemetry можно найти всю собранную браузером информацию о производительности и активности пользователя. Ссылка about:preferences отображает пользовательские настройки, а about:config — подробные сведения о конфигурации браузера, в том числе о том, производит ли браузер поиск по протоколу DoH (и с какими доверенными рекурсивными распознавателями), как было описано в предыдущем разделе, посвященном DNS.
Таким образом, URL-адреса можно применять не только для навигации по просторам Всемирной паутины, но и для использования старых протоколов (например, FTP и электронной почты), новых протоколов (для аудио- и видеоданных), а также для обеспечения удобного доступа к локальным файлам и информации браузера. Благодаря этому пропадает необходимость в любых специальных интерфейсных программах для вышеперечисленных целей, а интернет-доступ практически полностью интегрируется в одну программу: веб-браузер. Если бы мы не знали, что эту идею предложил британский физик, работавший в составе многонациональной исследовательской лаборатории в Швейцарии, то можно было бы подумать, что этот план разработан в рекламном отделе какой-нибудь софтверной компании.
Сторона сервера
О стороне клиента сказано уже достаточно много. Поговорим теперь о стороне сервера. Как мы уже знаем, когда пользователь вводит URL-адрес или кликает по гиперссылке, браузер производит синтаксический разбор URL-адреса и интерпретирует часть, заключенную между https:// и следующей косой чертой, как искомое DNS-имя. Вооружившись IP-адресом сервера, браузер устанавливает TCP-соединение с его портом 443. Затем отсылается команда, содержащая оставшуюся часть URL-адреса (путь к странице на данном сервере). Сервер возвращает браузеру ту страницу, которую он должен отобразить.
Если не вдаваться в детали, простой веб-сервер работает примерно так, как показано на илл. 6.6. Этому серверу передается имя файла, который нужно найти и отправить по сети. В обоих случаях в основном цикле сервер выполняет следующие действия:
1. Принимает входящее TCP-соединение от клиента (браузера).
2. Получает путь к странице, являющийся именем запрашиваемого файла.
3. Получает файл (с диска).
4. Высылает содержимое файла клиенту.
5. Разрывает TCP-соединение.
Современные веб-серверы обладают более широкими возможностями, однако в основе их работы лежат именно перечисленные шаги, которые предпринимаются в случае запроса контента из файла. Если контент динамический, третий шаг может быть заменен выполнением программы (указанной в пути), которая генерирует и возвращает определенный контент.
Если нужно обрабатывать сотни и даже тысячи запросов в секунду, веб-серверы работают иначе. Одна из проблем простой реализации состоит в том, что доступ к файлам часто становится узким местом производительности. Чтение с диска идет слишком медленно по сравнению с работой программы, и одни и те же файлы могут считываться несколько раз из-за вызовов операционной системы. Другая проблема заключается в том, что за раз может быть обработан только один запрос. При запросе большого файла обработка других запросов будет блокироваться до окончания его передачи.
Очевидное решение этой проблемы (применяемое на всех веб-серверах) состоит в том, чтобы кэшировать в памяти n последних запрошенных файлов или определенное количество гигабайтов контента. Прежде чем обратиться за файлом к диску, сервер проверяет содержимое кэша. Если файл есть в кэше, его можно сразу выдать клиенту, не обращаясь к диску. Конечно, для эффективного кэширования требуются большие объемы памяти и дополнительное время на проверку кэша и управление его содержимым, но суммарный выигрыш во времени почти всегда оправдывает эти издержки.
Параллельную обработку запросов также можно осуществить с помощью многопоточных (multithreaded) серверов. В одной из реализаций такого подхода сервер состоит из интерфейсного модуля, принимающего все входящие запросы, и k обрабатывающих модулей (илл. 7.22). Все k + 1 потоков принадлежат одному и тому же процессу, поэтому у обрабатывающих модулей есть доступ к кэшу в адресном пространстве процесса. Когда приходит запрос, интерфейсный модуль принимает его и создает краткую запись с его описанием. Затем запись передается одному из обрабатывающих модулей.
Сначала обрабатывающий модуль проверяет, нет ли запрашиваемого объекта в кэше. При наличии этого объекта в кэше он обновляет запись, включая в нее указатель на этот файл. Если искомого файла в кэше нет, обрабатывающий модуль обращается к диску и считывает файл в кэш (при этом, возможно, удаляя некоторые хранящиеся там файлы, чтобы освободить место). Считанный с диска файл помещается в кэш и отсылается клиенту.
Илл. 7.22. Многопоточный веб-сервер с интерфейсным модулем и набором обрабатывающих модулей
Преимущество такого подхода заключается в том, что пока один или несколько обрабатывающих модулей заблокированы в ожидании окончания дисковой или сетевой операции (при этом они не потребляют мощности центрального процессора), другие модули могут активно обрабатывать другие запросы. Имея k обрабатывающих модулей, производительность можно повысить в k раз по сравнению с однопоточным сервером. Конечно, если ограничивающим фактором являются диск или сеть, то необходимо наличие нескольких дисков или более быстрой сети, чтобы действительно улучшить однопоточную модель.
По сути, все современные веб-архитектуры построены по представленной выше схеме, с разделением на интерфейсную («фронтенд») и серверную («бэкенд») части. Интерфейсный веб-сервер часто называют обратным прокси-сервером (reverse proxy), поскольку он как посредник («прокси») извлекает содержимое из других серверов (обычно относящихся к серверной части) и доставляет эти объекты клиенту. Слово «обратный» указывает на то, что он действует от имени сервера, а не клиента.
При загрузке веб-страницы клиент сначала часто направляется (с использованием DNS) к обратному прокси-серверу (интерфейсному), который начинает возвращать веб-браузеру клиента статические объекты, чтобы он мог как можно скорее загрузить какое-то содержимое страницы. В это время серверная часть выполняет такие сложные операции, как поиск в интернете или базе данных, либо иное генерирование динамического контента, а затем возвращает клиенту результаты через обратный прокси-сервер.
7.3.2. Статичные веб-объекты
Основная идея Всемирной паутины состоит в доставке веб-страниц от сервера клиенту. В самом простом случае веб-объекты статические. Сегодня практически любая веб-страница имеет динамический контент, но в то же время даже на динамических страницах значительная часть содержимого (например, логотип, таблицы стилей, верхний и нижний колонтитулы) по-прежнему носит статичный характер. Статичные объекты — это размещенные на каком-либо сервере файлы, которые при каждом просмотре отображаются одинаково. Обычно их можно кэшировать, и даже на длительное время, поэтому они часто размещаются в ближайшем к пользователю объектном кэше. Но то, что страницы статичны, еще не значит, что при отображении в браузере они ведут себя пассивно. Ведь видеофайлы, к примеру, тоже представляют собой статичные объекты.
Как уже упоминалось, HTML — общепринятый язык Всемирной паутины, на котором написано большинство страниц. Домашние страницы преподавателей университетов, как правило, статичны. Сайты компаний могут быть динамическими, но конечным результатом динамического генерирования контента в любом случае будет HTML-страница. Язык HTML (HyperText Markup Language — язык разметки гипертекста) возник одновременно с появлением Всемирной паутины. С его помощью на веб-страницах можно размещать текст, изображения, видео, указатели на другие страницы и т.п. Это язык разметки, то есть язык для описания способа форматирования документов. Термин разметка (markup) восходит к тем дням, когда редактор с помощью специальной разметки указывал типографу, какой шрифт использовать для печати. Таким образом, языки разметки позволяют четко задавать команды форматирования. Например, в HTML тег <b> означает начало участка текста, выделенного полужирным шрифтом, а </b> указывает на конец такого участка. В свою очередь, тег <h1> указывает начало заголовка уровня 1. Другие языки разметки, хорошо известные академическим авторам, — LaTeX и TeX. Программа Microsoft Word, напротив, не является таким языком, поскольку она не встраивает в текст команды форматирования.
Главное преимущество языков разметки над языками, не имеющими явных команд форматирования, заключается в том, что они позволяют отделить контент от способа его представления. В большинстве современных веб-страниц для определения гарнитуры, цвета, размера, отступов и многих других атрибутов текста, списков, таблиц, заголовков, рекламных объявлений и других элементов используются таблицы стилей. Они пишутся на языке CSS (Cascading Style Sheets — каскадные таблицы стилей).
В итоге написание браузера не представляет большого труда: он должен лишь понимать команды разметки и содержимое таблиц стилей и применять все это к контенту. Благодаря встроенным стандартизированным командам разметки в HTML-файлах любой браузер может прочитать и переформатировать какую угодно страницу. Это критически важно, поскольку страницу, созданную, к примеру, на мощном компьютере с разрешением 3840 × 2160 и 24-битным цветом, часто приходится отображать на экране мобильного телефона с разрешением 640 × 320. Простое линейное масштабирование в данном случае плохая идея, поскольку шрифт при этом станет настолько мелким, что его невозможно будет прочитать.
Хотя такие документы, в принципе, можно создавать с помощью обычного текстового редактора, и многие именно так и поступают, лучше все же использовать для этого текстовые процессоры или специальные HTML-редакторы, которые берут большую часть работы на себя (но, соответственно, уменьшают степень контроля над отдельными элементами конечного результата). Также существует множество программ для создания веб-страниц, например Adobe Dreamweaver.
7.3.3. Динамические веб-страницы и веб-приложения
Модель статичной страницы, которую мы обсуждали до этого момента, рассматривает страницу как набор удобно связанных между собой документов (в том числе мультимедийных). Эта модель хорошо подходила для раннего интернета, когда в него было загружено огромное количество информации. Сегодня же интернет в основном используется для доступа к приложениям и сервисам, например для покупки товаров в интернет-магазине, поиска книги в каталоге библиотеки, использования онлайн-карт, чтения и отправки почты, а также совместного редактирования документа несколькими пользователями.
Эти новые области применения похожи на традиционное прикладное ПО (например, почтовые клиенты и текстовые редакторы). Однако в данном случае приложения запускаются в браузере, а пользовательские данные хранятся на серверах в центрах обработки данных, подключенных к интернету. Эти приложения используют веб-протоколы для получения информации через интернет и браузер для отображения пользовательского интерфейса. Преимущество состоит в том, что пользователю не нужно устанавливать отдельные приложения и он может получить доступ к своим данным с разных компьютеров, причем данные сохраняются у оператора сервиса. Этот подход оказался настолько успешным, что стал соперничать с использованием традиционного ПО. Конечно, немаловажен и тот факт, что эти приложения предоставляются крупными провайдерами бесплатно. По такой модели строится большая часть облачных вычислений (cloud computing), переводящих процесс вычисления с пользовательских компьютеров на совместно используемые кластеры серверов в интернете.
Чтобы выступать в роли приложения, веб-страницы больше не могут быть статичными. Они должны содержать динамический контент. Например, страница библиотечного каталога должна показывать, какие книги доступны на данный момент, а какие находятся на руках. Полезная страница фондовой биржи должна позволять пользователю взаимодействовать со страницей, чтобы просматривать курсы акций за разные периоды времени и рассчитывать прибыль и убытки. Как можно понять по этим примерам, динамический контент может генерироваться программами, запущенными на сервере или в браузере (или на обоих хостах).
Типичная ситуация показана на илл. 7.23. Например, представим себе картографический сервис, в котором можно ввести название улицы и затем просмотреть карту местности. Получив запрос, веб-сервер должен использовать программу для создания страницы, которая отображает карту запрашиваемой местности с помощью базы данных улиц и другой географической информации. Это шаги 1–3. Запрос (шаг 1) вызывает запуск программы на сервере. Программа опрашивает базу данных, генерирует нужную страницу (шаг 2) и возвращает ее в браузер (шаг 3).
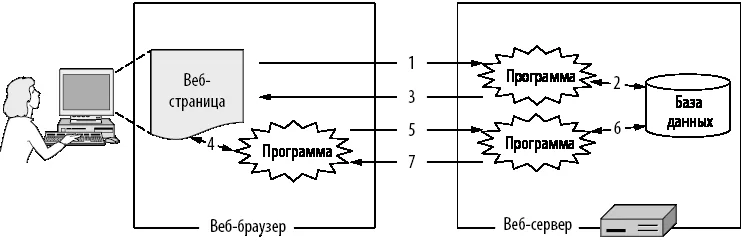
Илл. 7.23. Динамические страницы
Но это не весь динамический контент. Сама страница может содержать программы, которые запускаются в браузере. В нашем примере программа позволяет пользователю находить маршруты и исследовать соседние области с разными уровнями детализации. Она обновляет страницу, увеличивая или уменьшая масштаб в соответствии с запросами пользователя (шаг 4). Чтобы выполнить некоторые операции, программе может понадобиться больше данных с сервера. В этом случае она отправит запрос на сервер (шаг 5), который отыщет нужную информацию в базе данных (шаг 6) и вернет ответ (шаг 7). Затем программа продолжит вносить изменения на странице (шаг 4). Запросы и ответы обрабатываются в фоновом режиме; пользователь может и не знать о них, так как URL и название страницы обычно не меняются. Страница с программами, выполняющимися на стороне клиента, может предоставить более удобный интерфейс, чем страница, включающая только программы, выполняющиеся на сервере.
Динамическая генерация веб-страниц на стороне сервера
Давайте кратко обсудим динамическую генерацию веб-страниц на стороне сервера. Когда пользователь активирует в форме ссылку (например, чтобы купить некий товар), серверу по указанному в форме URL-адресу отправляется запрос с введенной пользователем информацией. Эти данные должны быть переданы скрипту или программе для обработки. Таким образом, URL-адрес идентифицирует программу для запуска, и данные из запроса передаются ей в качестве входной информации. Какую страницу вернет этот запрос, зависит от того, что произойдет в ходе его обработки. Результат не фиксирован, как в случае статичной страницы. При успешном оформлении заказа возвращаемая страница может содержать дату доставки товара. В противном случае она сообщит, что товар закончился или что кредитная карта пользователя недействительна.
То, как именно сервер запускает программу вместо поиска файла, зависит от устройства веб-сервера. В самих веб-протоколах это не определено. Именно поэтому интерфейс может быть защищен правом собственности, а браузеру не нужно знать детали. Что касается браузера, он просто создает запрос и получает страницу.
И все же для веб-серверов были разработаны стандартные API, чтобы запускать программы. Существование этих интерфейсов позволяет разработчикам тратить меньше усилий на расширение различных серверов за счет веб-приложений. Мы кратко рассмотрим два API, чтобы вы получили о них некоторое представление.
Первый API представляет собой метод обработки запросов динамических страниц, который был доступен с момента возникновения интернета. Он называется общим шлюзовым интерфейсом (Common Gateway Interface, CGI) и описан в RFC 3875. CGI предоставляет интерфейс, позволяющий веб-серверам общаться с серверными программами и скриптами, способными принимать некоторые входные данные (например, из формы) и в ответ генерировать HTML-страницы. Эти программы могут быть написаны на любом удобном для разработчика языке; обычно для упрощения разработки используется скриптовой язык. Можно выбрать Python, Ruby, Perl или любой другой язык на ваш вкус.
Существует договоренность, в соответствии с которой программы, запускаемые через CGI, должны размещаться в каталоге cgi-bin, который включается в URL-адрес. Сервер отображает запрос этого каталога на имя программы и запускает ее как отдельный процесс. В качестве входных данных программе передаются данные, отправленные вместе с запросом. На выходе программа выдает веб-страницу, которая возвращается браузеру.
Второй API предполагает совершенно иной подход. В данном случае в HTML-страницу встраиваются небольшие скрипты, которые выполняются сервером для генерирования страницы. Популярным инструментом для написания таких скриптов является язык PHP (PHP: Hypertext Preprocessor — PHP: препроцессор гипертекста). Для его использования необходимо, чтобы сервер понимал язык PHP (так же, как браузер должен понимать язык CSS, чтобы интерпретировать страницы с таблицами стилей). Обычно веб-страницы с PHP-кодом имеют расширение php, а не htm или html, что позволяет серверам легко их идентифицировать. В использовании PHP проще, чем CGI, и распространен повсеместно.
Несмотря на простоту в применении, PHP — мощный язык программирования для создания веб-интерфейсов и взаимодействия с серверными базами данных. В PHP есть переменные, строки, массивы и большинство управляющих структур, имеющихся в языке С, но при этом он обеспечивает более мощные возможности ввода/вывода по сравнению с процедурой printf. PHP имеет открытый исходный код, распространяется бесплатно и широко используется. PHP был разработан специально для сервера Apache, который также обладает открытым исходным кодом и является самым распространенным веб-сервером в мире.
Создание динамических веб-страниц на стороне клиента
Скрипты CGI и PHP решают вопросы обработки входных данных и взаимодействия с базами данных на сервере. Они могут принимать входящую информацию из форм, осуществлять поиск по одной или нескольким базам данных и в качестве результата генерировать HTML-страницы. Но ни один из этих методов не позволяет напрямую взаимодействовать с пользователем, например реагировать на движения мыши. Для этих целей необходимы скрипты, внедренные в HTML-страницы и выполняющиеся не на серверном, а на клиентском устройстве. Начиная с HTML 4.0, появилась возможность включать скрипты такого типа с помощью тега <script>. Текущий стандарт HTML сегодня принято называть HTML5. HTML5 содержит множество новых возможностей синтаксиса для встраивания мультимедийного и графического контента, включая теги <video>, <audio> и <canvas>. Элемент <canvas>, в частности, облегчает динамическое отображение двумерных форм и растровых изображений. Как ни странно, данный элемент вызывает большое беспокойство относительно конфиденциальности, поскольку свойства тега HTML <canvas> зачастую уникальны для разных устройств. Это позволяет операторам веб-сайтов следить за пользователями, даже если те избавятся от всех отслеживающих файлов cookie и скриптов.
Наиболее популярным языком для написания клиентских скриптов является JavaScript, поэтому мы немного поговорим о том, что он собой представляет. Об этом языке написано немало книг, к примеру работа Кодинга (Coding, 2019) или Атенсио (Atencio, 2020)35. Несмотря на схожесть названий, JavaScript не имеет практически ничего общего с языком программирования Java. Как и другие скриптовые языки, JavaScript — это язык с очень высоким уровнем абстракции: одной строкой JavaScript можно создать диалоговое окно, войти в цикл ожидания пользовательского ввода и сохранить полученную строку в переменной. Такой уровень абстракции идеален для разработки интерактивных веб-страниц. С другой стороны, тот факт, что JavaScript мутирует быстрее, чем мушка дрозофила под воздействием рентгеновских лучей, сильно усложняет написание на нем программ, способных работать на всех платформах. Возможно, однажды он станет более стабильным.
Хотя языки PHP и JavaScript схожи в том, что они встраивают код в HTML-файлы, важно понимать, что обработка кода при этом выполняется совершенно по-разному. При использовании PHP после щелчка по кнопке подтверждения браузер собирает всю введенную информацию в одну длинную строку и отправляет ее на сервер как запрос PHP-страницы. Сервер загружает PHP-файл и выполняет встроенный в него PHP-скрипт, получая на выходе новую HTML-страницу, которая возвращается браузеру для отображения. При этом браузер даже не знает, что страница была сгенерирована программой. Эта последовательность действий показана как шаги 1–4 на илл. 7.24 (а).
Илл. 7.24. (а) Сценарий PHP на стороне сервера. (б) Сценарий JavaScript на стороне клиента
В случае JavaScript после нажатия кнопки подтверждения браузер сам интерпретирует содержащийся на странице JavaScript-код. Вся работа производится локально, внутри браузера, без какого-либо взаимодействия с сервером. Эта последовательность действий показана как шаги 1 и 2 на илл. 7.24 (б). Как следствие, результат отображается практически мгновенно, тогда как при использовании PHP на доставку полученной HTML-страницы клиенту иногда уходит несколько секунд.
Эти отличия вовсе не означают, что JavaScript лучше, чем PHP. Просто у них совершенно разное назначение. PHP применяется для взаимодействия с серверной базой данных, а JavaScript (и другие языки для клиентской стороны) — для взаимодействия с пользователем на клиентском компьютере. Разумеется, как мы вскоре убедимся, PHP и JavaScript можно использовать одновременно.
7.3.4. HTTP и HTTPS
Теперь, когда мы имеем представление о веб-контенте и веб-приложениях, пора поговорить о протоколе, используемом для передачи всей этой информации от веб-сервера к клиенту и обратно. Это протокол передачи гипертекста (HyperText Transfer Protocol, HTTP), описанный в спецификации RFC 2616. Прежде чем вдаваться в подробности, стоит упомянуть о некоторых различиях между HTTP и его безопасной версией — защищенным протоколом передачи гипертекста (Secure HyperText Transfer Protocol, HTTPS). В сущности, оба протокола извлекают веб-объекты одинаково, и HTTP-стандарт для извлечения объектов развивается практически независимо от своей защищенной версии. HTTPS фактически использует HTTP поверх защищенного транспортного протокола защиты транспортного уровня (Transport Layer Security, TLS). В этой главе мы сосредоточимся на особенностях HTTP и истории его развития от первых версий до более современной HTTP/3. В главе 8 будет подробно рассмотрен TLS, который, по сути, является транспортным протоколом для HTTP, что в совокупности дает нам HTTPS. В оставшейся части этого раздела мы обсудим HTTP; HTTPS при этом можно рассматривать просто как HTTP, транспортируемый с помощью TLS.
Общие сведения
HTTP — простой запросно-ответный протокол. Его старые версии обычно запускаются поверх TCP, однако его самая последняя версия, HTTP/3, также нередко работает поверх UDP. Протокол HTTP определяет, какие сообщения клиент может отправлять серверу и что может быть возвращено в качестве ответа. Заголовки запросов и ответов, так же как в SMTP, даны в ASCII. Их содержимое имеет формат, похожий на MIME (опять же, как и в SMTP). Эта модель была одной из причин успеха Всемирной паутины на раннем этапе, так как сильно упрощала процесс разработки и развертывания.
В этом разделе мы поговорим о наиболее важных особенностях протокола HTTP в том виде, в каком он используется сегодня. Прежде чем вдаваться в детали, следует отметить, что подход к использованию этого протокола в интернете активно дорабатывается. HTTP — это протокол прикладного уровня, так как он работает поверх TCP и тесно связан с интернетом. Именно поэтому мы говорим о нем в этой главе. Но с другой стороны, HTTP все больше напоминает транспортный протокол, позволяющий процессам передавать контент из одной сети в другую. В качестве этих процессов могут выступать не только веб-браузер и веб-сервер. Так, медиаплеер может использовать HTTP для того, чтобы запросить у сервера информацию об альбоме. Антивирус — для загрузки последних обновлений вирусной базы. Разработчики — для получения файлов, относящихся к проекту, над которым они работают. Изделия бытовой электроники (например, цифровые фоторамки) часто используют встроенный HTTP-сервер как интерфейс, связывающий их с внешним миром. Коммуникация между компьютерами все чаще осуществляется при помощи HTTP. Например, сервер авиакомпании может связаться с сервером проката автомобилей и забронировать машину в рамках предлагаемого авиакомпанией турпакета.
Методы
HTTP был разработан специально для веб-технологий, но его намеренно сделали более универсальным, чем это было необходимо, в расчете на будущее применение в объектно-ориентированных приложениях. По этой причине HTTP позволяет запрашивать не только веб-страницы, но и операции, называемые методами.
Каждый запрос состоит из одной или нескольких строк ASCII-текста, где начальное слово в первой строке является именем вызываемого метода. Встроенные методы перечислены на илл. 7.25. Имена методов чувствительны к регистру символов, то есть метод GET существует, а метод get — нет.
Метод GET запрашивает у сервера страницу (под которой в общем случае подразумевается объект, но на практике это просто файл), закодированную согласно стандарту MIME. Большую часть запросов к веб-серверам составляют именно GET-запросы с простым синтаксисом. Типичный GET-запрос выглядит так:
GET filename HTTP/1.1
где filename — запрашиваемая страница, а 1.1 — используемая версия протокола.
Метод
Описание
GET
Чтение веб-страницы
HEAD
Чтение заголовка веб-страницы
POST
Добавить к веб-странице
PUT
Сохранить веб-страницу
DELETE
Удалить веб-страницу
TRACE
Отобразить входящий запрос
CONNECT
Подключиться через прокси
OPTIONS
Параметры запроса страницы
Илл. 7.25. Встроенные методы HTTP-запросов
Метод HEAD запрашивает только заголовок сообщения, без самой страницы. С его помощью можно собрать индексную информацию или просто проверить работоспособность URL-адреса.
Метод POST используется при подтверждении формы. Как и GET, он использует URL-адрес, но вместо простого извлечения страницы загружает данные (то есть содержимое формы или параметры) на сервер. Сервер выполняет над данными некое действие, которое зависит от URL-адреса, фактически добавляя их к объекту. В итоге происходит покупка указанного товара или вызов необходимой процедуры. Наконец, метод возвращает страницу с сообщением об этом результате.
Другие методы редко используются при просмотре веб-страниц. Метод PUT является противоположностью метода GET: он не читает, а записывает страницу. PUT позволяет создать набор веб-страниц на удаленном сервере. При этом тело запроса содержит страницу. Она может быть закодирована согласно стандарту MIME. В этом случае строки, следующие за командой PUT, могут содержать заголовки аутентификации, подтверждающие, что абонент обладает правами доступа к запрашиваемой операции.
Метод DELETE, как ни удивительно, удаляет страницу или, по крайней мере, сообщает, что веб-сервер дал согласие на ее удаление. Как и с методом PUT, важную роль здесь играет аутентификация и права доступа.
Метод TRACE предназначен для отладки. Он приказывает серверу отослать запрос обратно. Этот метод особенно полезен, когда запросы обрабатываются некорректно и клиенту необходимо узнать, какой именно запрос получает сервер.
Метод CONNECT предоставляет пользователю возможность подключиться к серверу через промежуточное устройство, такое как веб-кэш.
Метод OPTIONS позволяет клиенту запросить у сервера информацию о том, какие методы и заголовки можно использовать на указанной странице.
В ответ на каждый запрос включается строка состояния, часто вместе с дополнительной информацией (например, веб-страница целиком или ее часть). Эта строка может содержать трехразрядный код состояния, сообщающий об успешном выполнении запроса или о причинах неудачи. Первый разряд предназначен для разделения всех ответов на пять основных групп, перечисленных на илл. 7.26.
Код
Значение
Примеры
1xx
Информация
100 = сервер согласен обрабатывать запросы клиента
2xx
Успех
200 = запрос успешно обработан; 204 = содержимое отсутствует
3xx
Перенаправление
301 = страница перемещена; 304 = кэшированная страница все еще доступна
4xx
Ошибка клиента
403 = ошибка доступа; 404 = страница не найдена
5xx
Ошибка сервера
500 = внутренняя ошибка сервера; 503 = попробуйте еще раз позднее
Илл. 7.26. Группы кодов состояния, содержащиеся в ответах сервера
Коды, начинающиеся с 1 (1xx), на практике используются редко. Коды 2xx означают, что запрос был обработан успешно и данные (если их запрашивали) возвращены. Коды 3xx сообщают клиенту о том, что нужно попытать счастья в другом месте — используя либо другой URL, либо свой собственный кэш (мы обсудим его далее). Коды 4xx означают, что запрос по какой-либо причине, связанной с клиентом, потерпел неудачу: например, запрошена несуществующая страница или сам запрос некорректен. Наконец, коды 5xx сообщают о внутренних ошибках сервера, возникших из-за ошибки программы или временной перегрузки.
Заголовки сообщений
За строкой запроса (к примеру, содержащей метод GET) могут следовать другие строки с дополнительной информацией. Они называются заголовками запросов (request headers). Эти сведения можно сравнить с параметрами вызова процедуры. В свою очередь, ответы могут содержать заголовки ответов (response headers). Некоторые заголовки встречаются и там и там. Наиболее важные из них перечислены на илл. 7.27. Это длинный список, и как вы понимаете, каждый запрос и ответ может содержать целый набор заголовков.
Заголовок
Тип
Содержимое
User-Agent
Запрос
Информация о браузере и его платформе
Accept
Запрос
Тип страниц, поддерживаемых клиентом
Accept-Charset
Запрос
Поддерживаемые клиентом наборы символов
Accept-Encoding
Запрос
Поддерживаемые клиентом типы кодирования
Accept-Language
Запрос
Естественные языки, доступные клиенту
If-Modified-Since
Запрос
Время и дата последнего обновления
If-None-Match
Запрос
Теги, отправленные с последнего обновления
Host
Запрос
DNS-имя сервера
Authorization
Запрос
Список персональных идентификаторов клиента
Referer
Запрос
URL, с которого был отправлен предыдущий запрос
Cookie
Запрос
Отправка ранее принятого cookie-файла на сервер
Set-Cookie
Ответ
Сервер хочет, чтобы клиент сохранил cookie
Server
Ответ
Информация о сервере
Content-Encoding
Ответ
Тип кодирования содержимого (например, gzip)
Content-Language
Ответ
Естественный язык, используемый на странице
Content-Length
Ответ
Размер страницы в байтах
Content-Type
Ответ
MIME-тип страницы
Content-Range
Ответ
Идентифицирует часть контента страницы
Last-Modified
Ответ
Время и дата внесения последних изменений в страницу
Expires
Ответ
Время и дата, когда страница перестанет считаться действительной
Location
Ответ
Команда клиенту на пересылку его запроса по другому адресу
Accept-Ranges
Ответ
Сервер готов принимать запросы на страницы указанного размера
Date
Запрос/Ответ
Дата и время отправки сообщения
Range
Запрос/Ответ
Идентифицирует часть страницы
Cache-Control
Запрос/Ответ
Указание на то, как обрабатывать кэш
ETag
Запрос/Ответ
Тег для контента страницы
Upgrade
Запрос/Ответ
Протокол, на который хочет переключиться отправитель
Илл. 7.27. Некоторые заголовки сообщений протокола HTTP
С помощью заголовка User-Agent клиент может сообщить серверу версию своего браузера (например, Mozilla/5.0 или Chrome/74.0.3729.169). Эта информация позволяет серверу адаптировать свои ответы под конкретный браузер, так как логика работы и возможности разных браузеров серьезно отличаются.
Четыре заголовка, начинающиеся с Accept, сообщают серверу о том, какие типы информации готов принять клиент (если их набор ограничен). Первый из них указывает допустимые MIME-типы (например, text/html). Заголовок Accept-Charset указывает используемый клиентом набор символов (к примеру, ISO-8859-5 или Unicode-1-1). Заголовок Accept-Encoding указывает допустимые методы сжатия (например, gzip). Наконец, заголовок Accept-Language указывает естественный язык, используемый клиентом (например, испанский). Если сервер может выбирать из нескольких страниц, он подберет наиболее подходящий для клиента вариант согласно полученной информации. Если запрос удовлетворить невозможно, возвращается код ошибки, и запрос считается неудавшимся.
Заголовки If-Modified-Since и If-None-Match используются при кэшировании. Они позволяют клиенту запрашивать отправку страницы только в том случае, если в кэше нет доступной копии. Мы обсудим кэширование чуть позже.
Заголовок Host указывает имя сервера, содержащееся в URL-адресе. Этот заголовок обязателен, поскольку некоторые IP-адреса могут обслуживать несколько имен DNS одновременно, и серверу необходимо каким-то образом различать, кому передавать запрос.
Заголовок Authorization требуется в тех случаях, когда запрашивается защищенная страница. С его помощью клиент может подтвердить свои права на ее просмотр.
Клиент использует заголовок Referer (не соответствующий правилам английской орфографии), чтобы сообщить, с какого URL-адреса был выполнен переход на запрашиваемый URL-адрес. Чаще всего это URL-адрес предыдущей страницы. Этот заголовок крайне полезен для отслеживания процесса просмотра веб-страниц, поскольку позволяет серверу узнать, каким образом клиент попал на ту или иную страницу.
Файлы cookie представляют собой небольшие файлы, которые размещаются серверами на клиентских устройствах с целью запоминания информации на будущее. Типичный пример — сайт интернет-магазина, использующий файл cookie на стороне клиента для отслеживания того, какие товары он уже успел заказать. При каждом добавлении товара в корзину производится обновление файла cookie, чтобы он содержал сведения обо всех заказах. Несмотря на то что файлы cookie описываются в спецификации RFC 2109, а не в спецификации RFC 2616, в них тоже используются заголовки. Заголовок Set-cookie определяет то, как серверы отправляют файлы cookie клиентам. Предполагается, что клиент сохранит у себя cookie и вернет его вместе со следующим запросом на сервер при помощи заголовка Cookie. (Обратите внимание, что существует и более поздняя спецификация для файлов cookie с обновленными заголовками, RFC 2965, но она не слишком распространена.)
В ответах используется множество других заголовков. Заголовок Server позволяет серверу указать версию своего программного обеспечения. Следующие пять заголовков, начинающиеся с Content-, позволяют серверу описать свойства отправляемой им страницы.
Заголовок Last-modified содержит дату и время внесения последних изменений в отправляемую страницу, а заголовок Expires сообщает, сколько времени страница будет доступна. Оба они играют важную роль при кэшировании страницы.
С помощью заголовка Location сервер сообщает, что клиента нужно перенаправить на другой URL-адрес. Это может потребоваться при «переезде» страницы на другой адрес или если нужно разрешить использование нескольких URL-адресов для ссылки на одну и ту же страницу (возможно, на разные сервера). Этот заголовок также нередко применяется компаниями, главная веб-страница которых прописана в домене com, однако клиенты перенаправляются с нее на национальные или региональные страницы, в соответствии с IP-адресом клиента или выбранным языком.
Если страница крупная, мелкий клиент может не захотеть принять ее сразу целиком. Некоторым серверам можно отправлять запросы, ограничивающие размеры страниц, отсылаемых за один раз. Если страница оказывается слишком большой, она будет разбита на более мелкие единицы и выслана в несколько приемов. Заголовок Accept-Ranges сообщает о том, что сервер готов работать таким образом.
Теперь перейдем к заголовкам, которые могут быть использованы в обоих направлениях. Заголовок Date применяется как в запросах, так и в ответах и содержит время и дату отправки сообщения. Заголовок Range сообщает, какой диапазон байтов страницы предоставляется в качестве ответа.
Заголовок ETag сообщает короткий тег, выполняющий роль имени контента страницы. Он применяется для кэширования. Заголовок Cache-Control выдает другие четкие указания о том, как кэшировать (а чаще — как не кэшировать) страницы.
Заголовок Upgrade используется для переключения на другой протокол обмена данными, например на новую версию HTTP или на защищенный способ передачи данных. Он позволяет клиенту и серверу сообщить, что именно они поддерживают.
Кэширование
Мы часто возвращаемся на страницы, которые уже просматривали ранее, а на связанных веб-страницах нередко размещаются одни и те же ресурсы: например, изображения, которые используются для навигации по сайту, а также стандартные таблицы стилей и скрипты. Было бы крайне неэкономично получать все эти ресурсы страниц каждый раз, когда они отображаются, ведь у браузера уже есть их копии.
Сохранение полученных страниц для дальнейшего использования называется кэшированием (caching). Преимущество этого метода в том, что страница, сохраненная в кэше, может быть использована снова, при этом не обязательно повторять передачу. У HTTP есть встроенная поддержка кэширования, чтобы помочь клиентам узнать, могут ли они безопасно использовать страницы повторно. Эта поддержка повышает производительность, сокращая и трафик, и время ожидания. Недостаток в том, что теперь браузер должен хранить страницы, но это почти всегда оправданно, так как локальное хранение информации не требует серьезных затрат ресурсов. Обычно страницы хранятся на диске, так что они могут быть использованы, когда браузер будет запущен в следующий раз.
С HTTP-кэшированием связан непростой вопрос: как определить, что сохраненная копия страницы соответствует тому, как она будет выглядеть при следующем вызове. Такой вывод не может быть сделан только на основании совпадения URL. Допустим, URL ведет на страницу с последними новостями. Этот контент будет постоянно обновляться, хотя URL останется тем же. Если же на странице содержится список богов греческой и римской мифологии, она будет меняться гораздо реже.
HTTP использует две стратегии решения этой проблемы. Они отображены на илл. 7.28 как формы обработки между запросом (шаг 1) и ответом (шаг 5). Первая стратегия — это проверка действительности страницы (шаг 2). Запрашивается кэш, и если в нем есть свежая (то есть действительная) копия страницы заданного URL, получать новую копию с сервера нет необходимости. Вместо этого сохраненная в кэше страница может быть возвращена напрямую. Когда кэшированная страница была первоначально получена с сервера, вместе с ней был получен заголовок Expires. Его содержание, а также текущие дата и время используются, чтобы сделать заключение о действительности страницы.
Илл. 7.28. Кэширование HTTP
Однако не все страницы приходят с удобным заголовком Expires, сообщающим, когда страница должна быть получена снова. В конце концов, строить догадки тяжело, особенно о будущем. В этом случае браузер может использовать эвристические правила. Например, если страница не была изменена за последний год (как сказано в заголовке Last-Modified), логично предположить, что она не изменится за ближайший час. Хотя гарантий нет, и этот прогноз может не оправдаться. Например, биржа может закрыться на ночь, и ее страница не будет обновляться несколько часов, но как только начнется следующая торговая сессия, изменения будут вноситься постоянно. Таким образом, оправданность кэширования может серьезно варьироваться в зависимости от периода времени. По этой причине эвристические правила нужно использовать с осторожностью, хотя в основном они работают очень хорошо.
Обнаружение страниц, которые не были изменены за определенный промежуток времени, — наиболее выгодный способ использования кэширования, так как в этом случае не нужно связываться с сервером. К сожалению, этот подход не всегда работает. Сервер должен использовать заголовок Expires осторожно, поскольку не всегда известно, когда на странице будут внесены изменения. Таким образом, кэшированные копии могут быть свежими, но клиент этого не знает.
В этом случае используется вторая стратегия — с сервера запрашивается информация о действительности сохраненной копии страницы. Такой запрос называют GET-запросом с условием (conditional GET). Он показан на илл. 7.28 как шаг 3. Если сервер знает, что копия в кэше все еще актуальна, он может отправить короткий ответ, подтверждая это (шаг 4а). В ином случае он должен отослать полный ответ (шаг 4б).
Существует еще несколько полей заголовков, которые используются для того, чтобы сервер мог проверить, действительна ли копия на момент запроса. Клиент знает, когда на страницу были внесены последние изменения, благодаря заголовку Last-Modified. Он может выслать это время серверу, используя заголовок If-ModifiedSince, чтобы запросить страницу только в том случае, если она была изменена после последнего кэширования. О кэшировании можно было бы рассказать еще очень много, поскольку оно сильно влияет на производительность, однако мы не будем раскрывать это в нашей книге. При желании вы легко найдете множество учебных пособий на эту тему в интернете по запросу «веб-кэширование».
HTTP/1 и HTTP/1.1
Обычно при установке связи с сервером браузер устанавливает TCP-соединение с портом 443 сервера для HTTPS (или портом 80 для HTTP), хотя формально эта процедура необязательна. Ценность использования TCP в том, что ни браузерам, ни серверам не приходится беспокоиться о том, что делать со слишком длинными сообщениями, надежностью и контролем перегрузки. Все это обеспечивается протоколом TCP.
Изначально в интернете использовался протокол HTTP/1.0, и после установления соединения отсылался один запрос, на который приходил один ответ. После этого TCP-соединение разрывалось. Тогда типичная веб-страница целиком состояла из HTML-текста, и такой способ взаимодействия был подходящим. Однако вскоре рядовая веб-страница наполнилась многочисленными встроенными ссылками на различные значки и другие декоративные элементы. Установление отдельного TCP-соединения для передачи каждого значка стало слишком затратным.
Позже был создан протокол HTTP/1.1, поддерживающий постоянные соединения (persistent connection), что позволило устанавливать TCP-соединения, отправлять запросы, получать ответы, а затем передавать и принимать дополнительные запросы и ответы. Эта стратегия называется повторным использованием соединения (connection reuse). Таким образом снизились накладные расходы, возникавшие при постоянных установках и разрывах соединения. Стало возможным также конвейеризировать запросы, то есть отправлять запрос 2 еще до прибытия ответа на запрос 1.
Разница в производительности между этими тремя случаями показана на илл. 7.29. В части (а) мы видим три запроса, отсылаемых один за другим, при этом для каждого устанавливается отдельное соединение.
Предположим, что это представление страницы с двумя встроенными картинками, которые находятся на одном сервере. URL изображений определяется при получении главной страницы, так что они приходят после нее. Сегодня на среднестатистической странице присутствует около 40 других объектов, которые должны быть получены для ее отображения; но это сделало бы наш рисунок огромным. Так что в данном примере мы используем всего два встроенных объекта.
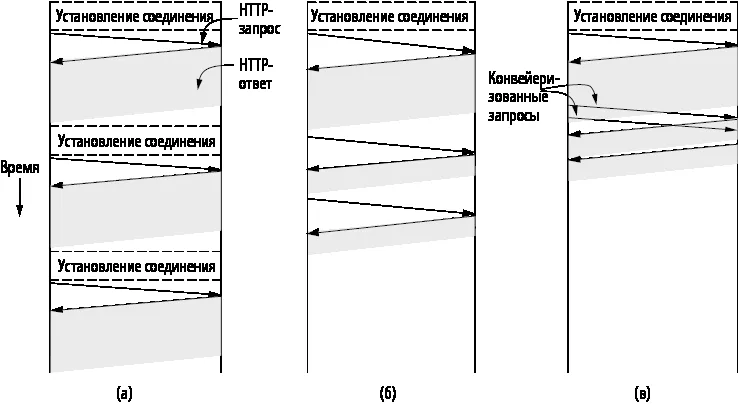
Илл. 7.29. HTTP. (а) Множественные соединения и последовательные запросы. (б) Постоянное соединение и последовательные запросы. (в) Постоянное соединение и конвейеризованные запросы
На илл. 7.29 (б) страница получена через постоянное соединение. То есть TCP-соединение открывается с самого начала, затем отсылаются те же самые три запроса, как и раньше, один за другим, и только после этого соединение закрывается. Заметьте, что загрузка завершается быстрее. Это происходит по двум причинам: во-первых, не тратится время на установление дополнительных соединений (для каждого TCP-соединения требуется дополнительное время, как минимум для его подтверждения). Во-вторых, передача тех же картинок проходит быстрее. Почему же? Все это из-за контроля перегрузок сети в TCP. Сразу после установления соединения TCP использует процедуру медленного старта, чтобы увеличить пропускную способность, пока он не изучит поведение сетевого пути. Вследствие этого периода «разогрева» на передачу информации посредством множественных коротких TCP-соединений уходит гораздо больше времени, чем в случае с одним длительным TCP-соединением.
Наконец, на илл. 7.29 (в) установлено одно постоянное соединение, а запросы передаются конвейеризованно. Второй и третий запросы быстро отсылаются друг за другом, так как была получена достаточно большая часть главной страницы, чтобы можно было принять решение о загрузке и отображении картинок. В конечном итоге приходят ответы на эти запросы. Этот метод сокращает время, в течение которого сервер простаивает, так что это еще больше повышает производительность.
Однако за постоянные соединения приходится платить. Возникает новый вопрос: когда закрывать соединение? Соединение с сервером не должно разрываться, пока загружается страница. А что потом? Высок шанс того, что пользователь нажмет на ссылку, которая запросит еще одну страницу с сервера. Если соединение остается открытым, следующий запрос может быть отправлен немедленно. Но гарантии того, что клиент создаст запрос к серверу в ближайшее время, нет. На практике клиенты и серверы обычно сохраняют постоянное соединение, пока не пройдет какой-то небольшой промежуток времени (например, 60 с), в течение которого не будет отправлено ни одного запроса и не будет принято ни одного ответа, или же если открыто слишком много соединений и некоторые нужно закрыть.
Внимательный читатель мог заметить, что существует одна комбинация, о которой мы пока не упомянули. Можно также отсылать один запрос по одному TCP-соединению, но устанавливать эти соединения одновременно. Метод параллельных соединений (parallel connection) широко использовался браузерами до появления постоянных соединений. У него тот же недостаток, что и у последовательных соединений — дополнительные служебные операции, — но производительность гораздо выше. Так происходит из-за того, что параллельное установление и увеличение числа соединений занимает некоторое количество времени. В нашем примере соединения для обоих встроенных изображений могут быть установлены в одно и то же время. Однако запуск большого числа TCP-соединений с одним и тем же сервером не лучшая идея, поскольку TCP отслеживает перегрузки для каждого соединения отдельно. В результате соединения соревнуются друг с другом, вызывая дополнительные потери пакетов, и в общем являются более агрессивными пользователями сети, чем индивидуальные соединения. Постоянные соединения превосходят параллельные и являются более предпочтительными, так как избегают ненужных издержек и не страдают от проблем с перегрузками.
HTTP/2
На заре интернета использовался протокол HTTP/1.0; а в 2007 году была создана версия HTTP/1.1. К 2012 году он уже немного устарел, в связи с чем IETF создал рабочую группу для разработки следующей версии HTTP/2. Отправной точкой при этом служил протокол SPDY, уже разработанный компанией Google. Окончательный результат был опубликован в мае 2015 года в виде спецификации RFC 7540.
Рабочая группа стремилась достигнуть нескольких целей, в том числе:
1. Предоставление клиентам и серверам возможности выбирать, какую версию HTTP использовать.
2. Поддержка максимальной совместимости с версией HTTP/1.1.
3. Повышение производительности за счет мультиплексирования, конвейеризации, сжатия и т.д.
4. Поддержка существующих методов, используемых браузерами, серверами, прокси-серверами, сетями доставки и т.д.
Ключевой идеей было обеспечение обратной совместимости. Предполагалось, что существующие приложения смогут работать с HTTP/2, а вновь создаваемые приложения — использовать новые функции для повышения производительности. По этой причине заголовки, URL-адреса и общая семантика почти не претерпели изменений. При этом поменялись способы кодирования и взаимодействия клиентов с серверами. В случае HTTP/1.1 клиент устанавливает TCP-соединение с сервером, отправляет запрос в виде текста, ожидает ответа, после чего обычно разрывает соединение. Это повторяется столько раз, сколько нужно для доставки всей страницы. В HTTP/2 после установления TCP-соединения можно отправить много запросов в двоичном виде, с возможностью их приоритизации, а сервер может отвечать на них в любом удобном для него порядке. TCP-соединение разрывается лишь после отправки ответов на все запросы.
Используя механизм push на стороне сервера (server push), протокол HTTP/2 позволяет серверу «проталкивать» файлы, которые, по его мнению, понадобятся клиенту, хотя изначально тот может об этом и не знать. Например, если сервер видит, что запрошенная клиентом страница использует таблицу стилей и файл JavaScript, то он может отправить их еще до того, как клиент их запросит. Это позволяет устранить часть задержек. На илл. 7.30 показано, как одна и та же информация (веб-страница с таблицей стилей и двумя изображениями) может быть получена с помощью протоколов HTTP/1.1 и HTTP/2.
Обратите внимание, что на илл. 7.30 (а) показан наиболее благоприятный случай для протокола HTTP/1.1, при котором можно последовательно отправить несколько запросов по одному и тому же TCP-соединению, но при этом обработка запросов и возвращение результатов должны выполняться с соблюдением исходного порядка. В HTTP/2 (илл. 7.30 (б)) возвращение ответов может производиться в любом порядке. Например, если картинка 1 очень большая, сервер может сначала вернуть картинку 2, чтобы с ней браузер мог начать отображение страницы еще до того, как получит картинку 1. В HTTP/1.1 это недопустимо. Также обратите внимание, что на илл. 7.30 (б) сервер отправил таблицу стилей еще до того, как браузер ее запросил.
Наряду с конвейеризацией и мультиплексированием запросов в рамках одного TCP-соединения HTTP/2 производит сжатие заголовков и отправляет их в двоичном виде для экономии пропускной способности и уменьшения задержки. Сеанс протокола HTTP/2 состоит из серии фреймов, снабженных отдельными идентификаторами. Ответы могут поступать обратно в ином порядке, нежели запросы (илл. 7.30 (б)), но поскольку каждый ответ содержит идентификатор запроса, браузер может определить, какому из них соответствует тот или иной ответ.
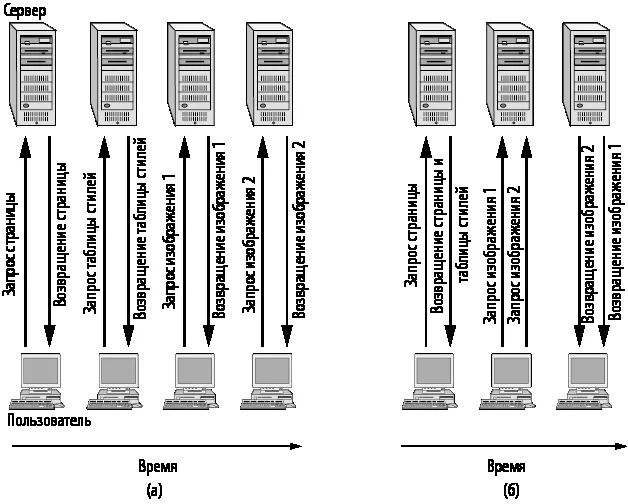
Илл. 7.30. (а) Получение веб-страницы с помощью HTTP/1.1. (б) Получение той же страницы с помощью HTTP/2
Острым вопросом в ходе разработки версии HTTP/2 стала необходимость шифрования. Одни разработчики активно выступали за шифрование, другие столь же отчаянно выступали против. Аргументы противников главным образом были связаны с технологией IoT, где каждое устройство имеет весьма ограниченную вычислительную мощность. В итоге шифрование в HTTP/2 не обязательно, но поскольку его требуют все современные браузеры, оно все равно применяется, по крайней мере при просмотре веб-сайтов.
HTTP/3
HTTP/3, или просто H3, — это третья крупная версия протокола HTTP, призванная заменить HTTP/2. Главное отличие HTTP/3 состоит в использовании другого транспортного протокола для пересылки HTTP-сообщений: вместо TCP здесь используется QUIC — версия протокола UDP, дополненная контролем перегрузки пользовательского пространства. Версия HTTP/3, которую изначально назвали просто HTTP-over-QUIC (HTTP поверх QUIC), является последней крупной переработкой протокола HTTP. Существует множество библиотек с открытым исходным кодом, которые обеспечивают поддержку клиентской и серверной логики для QUIC и HTTP/3 в таких языках, как C, C++, Python, Rust и Go. Популярные веб-серверы, включая nginx, теперь тоже позволяют использовать HTTP/3, установив соответствующие патчи.
Транспортный протокол QUIC поддерживает мультиплексирование потоков и примерно такой же механизм управления отдельными потоками, какой предлагался в версии HTTP/2. Надежность на уровне потока и контроль перегрузок в масштабе соединения существенно повышают производительность HTTP. Все потому, что информация о перегрузках может использоваться во время нескольких сеансов, а затраты на обеспечение надежности распределяются между множеством соединений, которые доставляют объекты параллельно. При наличии соединения с конечной точкой сервера HTTP/3 позволяет клиенту повторно использовать то же соединение с множеством различных URL-адресов.
Версия HTTP/3, использующая протокол HTTP поверх QUIC, теоретически может значительно увеличить производительность по сравнению с версией HTTP/2 (в основном за счет преимуществ QUIC над TCP). В некоторой степени протокол QUIC можно рассматривать как следующее поколение TCP. Он обеспечивает настройку соединения без дополнительных кругов передачи между клиентом и сервером. Если между ними уже устанавливалось соединение, его можно восстановить без кругов передачи (при условии, что в ходе предыдущего соединения был создан и сохранен в кэше секретный ключ). Протокол QUIC гарантирует надежную доставку байтов в пределах одного потока в исходном порядке, но не дает никаких гарантий относительно байтов в других QUIC-потоках. Хотя QUIC позволяет доставлять данные в рамках потока без соблюдения изначального порядка, HTTP/3 не использует эту возможность. Версию HTTP/3 на базе QUIC планируется применять исключительно в сочетании с защищенной версией HTTP — HTTPS. URL-адреса с HTTP-запросами (которые теперь используются все реже) не будут обновляться для версии HTTP/3. Более подробные сведения о протоколе HTTP/3 см. по адресу https://http3.net.
7.3.5. Конфиденциальность в интернете
Крайне актуальной проблемой в последние годы стало обеспечение конфиденциальности при просмотре веб-страниц. Веб-сайты, веб-приложения и сторонние трекеры часто применяют механизмы HTTP для отслеживания поведения пользователей как в рамках одного веб-сайта или приложения, так и по всему интернету. Также для этого могут использоваться некоторые дополнительные информационные каналы в браузере или устройстве. В этом разделе описаны некоторые из механизмов отслеживания и снятия цифрового отпечатка отдельных пользователей и устройств.
Файлы cookie
Один из традиционных способов отслеживания — размещение на клиентских устройствах файлов cookie (по сути, небольшого количества данных), позже высылаемых клиентами обратно при последующем посещении какого-нибудь сайта. Когда пользователь запрашивает веб-объект (например, веб-страницу), веб-сервер может разместить на устройстве пользователя фрагмент персистентного состояния в виде файла cookie, используя директиву «set-cookie» протокола HTTP. Данные, переданные на устройство клиента с помощью этой директивы, локально сохраняются на нем. При последующем посещении устройством этого веб-домена HTTP-запрос наряду с самим запросом передаст и файл cookie.
Собственные файлы cookie (они устанавливаются доменом посещаемого веб-сайта: интернет-магазина или новостного сайта) применяются для улучшения пользовательского опыта. Например, файлы cookie часто используются для сохранения состояния в рамках веб-сеанса. С их помощью сайт отслеживает полезную информацию о текущем поведении пользователя, например о том, как давно он авторизовался и какие товары он добавил в корзину.
Файлы cookie, установленные одним доменом, обычно видны только этому домену. Например, если некая рекламная сеть установит cookie на устройство пользователя, то он будет виден только ей и никому другому. Эта стратегия веб-безопасности, называемая политикой одного источника (same-origin policy), предотвращает чтение одной из сторон файла cookie, установленного другой стороной, и в какой-то мере ограничивает распространение информации об отдельных пользователях.
Хотя собственные файлы cookie часто используются для улучшения пользовательского опыта, третьи лица (рекламодатели и компании, занимающиеся отслеживанием посетителей) также могут установить cookie на клиентское устройство, чтобы узнать, на какие сайты заходит пользователь. Это происходит так:
1. При посещении веб-сайта помимо контента, который запрашивается напрямую, устройство может загрузить контент со сторонних сайтов, в том числе с доменов рекламных сетей. Загрузка рекламы или скрипта позволяет третьей стороне установить уникальный файл cookie на устройство пользователя.
2. Впоследствии этот пользователь может посетить другие сайты, которые будут загружать веб-объекты той же третьей стороны, что позволит ей установить отслеживающую информацию на разных сайтах.
Приведем типичный пример такой практики: два разных веб-сайта используют одну и ту же рекламную сеть для доставки объявлений. В этом случае рекламная сеть видит следующее:
1. Устройство пользователя возвращает файл cookie, установленный на втором веб-сайте.
2. Заголовок Referer HTTP-запроса на загрузку объекта из рекламной сети сообщает, с какого сайта устройство пользователя перешло на текущий сайт. Это называют межсайтовым отслеживанием (cross-site tracking).
Супер-cookie и другие локально сохраняемые идентификаторы отслеживания (которые пользователь не может контролировать, в отличие от обычных cookie) позволяют прокси-серверу отслеживать поведение пользователя в течение долгого времени. Уникальные идентификаторы могут включать сторонние идентификаторы отслеживания, кодируемые в заголовках HTTP (точнее, в заголовках HSTS (HTTP Strict Transport Security — строгая безопасность передачи информации по протоколу HTTP), которые не удаляются при чистке файлов cookie, и в тегах, которые третья сторона (например, провайдер мобильного интернета) может вставлять в незашифрованный трафик определенного сегмента сети. Это позволяет рекламодателям и другим заинтересованным сторонам формировать профиль посещений пользователя подобно отслеживающим файлам cookie, которые используются рекламными сетями и поставщиками приложений.
Сторонние трекеры
Файлы cookie сторонних доменов, которые используются на нескольких сайтах, позволяют рекламной сети или другой третьей стороне отслеживать поведение пользователя на любом сайте, где эти файлы будут установлены (то есть на любом сайте с рекламными объявлениями, кнопками «Поделиться» и другим встроенным кодом от данной рекламной сети). Отслеживание паттернов просмотра, свойственных пользователю, как правило, происходит в рамках набора сайтов, которые он посещает. При этом зачастую применяется отслеживающее ПО на базе браузера. Иногда третья сторона разрабатывает собственное ПО для отслеживания (например, для веб-аналитики). Также она может использовать сервис другой третьей стороны, позволяющий собирать и агрегировать нужные сведения на разных сайтах.
Некоторые сайты позволяют рекламным сетям и прочим сторонним трекерам работать на своих страницах, собирать аналитические данные, перенаправлять рекламу на другие веб-сайты (осуществлять ретаргетинг) и монетизировать доступное рекламное пространство, размещая тщательно таргетированные объявления. Рекламодатели собирают данные о пользователях с помощью различных механизмов отслеживания, включая файлы cookie, объекты HTML5, JavaScript-код, опознавание устройств и браузеров и другие популярные веб-технологии. Если пользователь посещает ряд веб-сайтов, которые сотрудничают с одной рекламной сетью, она распознает устройство пользователя и отслеживает его поведение в динамике.
С помощью отслеживающего ПО рекламная сеть или другая третья сторона может получить информацию о поведении пользователя в социальных сетях, о его контактах, предпочтениях, интересах, покупках и т.д. Это позволяет точно установить, привела ли реклама к совершению покупки, изучить связи между людьми, создать подробные профили отслеживания, осуществить качественный таргетинг, а также многое другое в силу масштабности отслеживания.
Индивидуальное отслеживание пользователей с помощью сторонних (или собственных) трекеров возможно, даже если человек не зарегистрирован в конкретном сервисе (социальной сети или поисковой системе), перестал его использовать или вышел из системы. При этом на сегодняшний день сторонние трекеры все больше сосредоточиваются в руках крупных провайдеров.
Наряду с применением файлов cookie существуют и другие методы стороннего отслеживания. Среди них снятие цифрового отпечатка пользователя (разновидность цифрового отпечатка браузера), повтор сеанса (позволяющий третьей стороне воспроизвести все взаимодействия пользователя с конкретной страницей) и даже использование функции автозаполнения браузера или менеджера паролей для возвращения данных из веб-форм еще до заполнения пользователем всей формы. Эти усовершенствованные технологии позволяют получить подробные сведения о поведении и данных пользователя, включая такие детали, как число прокруток страницы и щелчков мыши, а в некоторых случаях даже логин и пароль для конкретного сайта (придуманные самим пользователем или созданные автоматически).
Согласно недавнему исследованию, определенные виды стороннего отслеживающего ПО используются повсеместно. При этом новостные сайты содержат наибольшее количество сторонних трекеров на любом собственном сайте. Кроме того, отслеживание широко применяется на сайтах, посвященных искусству и спорту, а также на торговых площадках. Перекрестное отслеживание устройств (cross-device tracking) подразумевает установление связи между действиями пользователя на нескольких устройствах (настольных ПК, планшетах, смартфонах и т.д.). Это позволяет собрать данные о поведении человека, даже если он использует разные устройства.
Перекрестное отслеживание устройств может оказаться полезным. Например, оно способно повысить качество пользовательского опыта. При использовании файлов cookie на одном устройстве или в одном браузере оно обеспечивает комфортный переход между устройствами (например, позволяя продолжить чтение книги или просмотр фильма с того места, где пользователь остановился в прошлый раз). Также перекрестное отслеживание помогает предотвращать мошенничество. Если пользователь авторизовался с незнакомого устройства в совершенно новом месте, поставщик услуг может выполнить дополнительные действия по его аутентификации (например, использовать двухфакторную аутентификацию).
Хотя перекрестное отслеживание устройств больше применяется для собственных сервисов, в частности, провайдерами почтового сервиса, контента (например, потокового видео) или интернет-магазинами, сторонние трекеры тоже все чаще отслеживают поведение пользователей на нескольких устройствах.
1. Перекрестное отслеживание устройств может быть детерминированным, основанным на постоянном идентификаторе (например, логине, привязанном к конкретному пользователю).
2. Оно также может носить вероятностный характер; в качестве вероятностного идентификатора можно использовать IP-адрес. Например, трансляция сетевого адреса может привести к тому, что несколько устройств в сети будут иметь одинаковый публичный IP-адрес. Допустим, пользователь посещает веб-сайт с мобильного устройства (например, смартфона), используя его и дома, и на работе. Третья сторона может задать информацию об IP-адресе в расположенных на устройствах файлах cookie. Тогда этот пользователь сможет появляться с двух публичных IP-адресов (с одного на работе и со второго дома), и эти IP-адреса будут связаны между собой с помощью того же стороннего файла cookie. Если пользователь посетит сайт третьей стороны с других устройств, которые также используют один из этих IP-адресов, их можно будет с большой долей уверенности привязать к тому же пользователю.
Детерминированный и вероятностный подходы часто совмещаются; при этом зачастую для реализации такого отслеживания даже не требуется, чтобы пользователь авторизовался на каком-либо сайте. Иногда третья сторона предлагает сервисы «аналитики», которые встраиваются на множество веб-сайтов, не имеющих отношения к разработчикам этих сервисов. Это позволяет третьей стороне отслеживать поведение пользователя в рамках нескольких сайтов и устройств. Третьи стороны часто сотрудничают друг с другом с целью перекрестного отслеживания пользователей с помощью синхронизации cookie-файлов (мы подробно рассмотрим ее далее в этом разделе).
Перекрестное отслеживание устройств делает возможным более продвинутый логический вывод общей информации о действиях пользователя за счет сочетания данных, полученных с разных устройств. Данные о местоположении пользователя (полученные с мобильного устройства) можно объединить с историей поиска и сведениями о его активности в социальной сети (например, количестве поставленных лайков). Эти сведения помогут определить, посетил ли он физический магазин после поиска в интернете или после просмотра рекламного объявления.
Снятие цифрового отпечатка устройства и браузера
Даже когда пользователи отключают такие распространенные механизмы отслеживания, как сторонние cookie, веб-сайты и третьи стороны по-прежнему могут их отслеживать, используя информацию, которая возвращается устройством серверу (об окружении, контексте и устройстве). Основываясь на таком наборе сведений, третьей стороне часто удается однозначно идентифицировать пользователя, то есть создать его цифровой отпечаток на разных сайтах в течение некоторого времени.
Один из популярных методов — снятие цифрового отпечатка хоста (canvas fingerprinting), при котором для идентификации устройства используется тег HTML <canvas>. Этот тег позволяет веб-приложениям отображать графику в режиме реального времени. Из-за различий в размерах, способе рендеринга шрифтов, подходе к сглаживанию и т.д. устройства могут по-разному отображать картинки, и результирующие пиксели можно использовать в качестве цифрового отпечатка. Данный метод был впервые обнаружен в 2012 году, но широкая общественность узнала о нем только в 2014 году. Несмотря на предпринятые ответные меры, многие трекеры продолжают использовать этот подход, а также схожие методы (например, идентификация устройства с помощью снятия цифрового отпечатка на основе браузерных списков шрифтов). Недавнее исследование показало, что снятие цифрового отпечатка по-прежнему используется на тысячах сайтов. Также устройства можно отследить с помощью API браузеров, например, извлекая информацию о состоянии аккумулятора: уровень его заряда и время разрядки. В ряде исследований описывается, как такая информация помогает отследить устройство и ассоциировать его с пользователем (Олейник и др.; Olejnik et al., 2015).
Синхронизация cookie-файлов
Обмениваясь информацией, сторонние трекеры могут отслеживать отдельных пользователей даже при посещении веб-сайтов с разными механизмами отслеживания. Трудно поддающийся выявлению метод синхронизации cookie-файлов (cookie syncing) позволяет отдельным третьим сторонам легко объединить свои наборы сведений о конкретных пользователях, что создает серьезную угрозу конфиденциальности. Согласно последним исследованиям, сторонние трекеры широко используют данный метод.
35 Издательский дом «Питер» предлагает книги по JavaScript как для новичков, так и для специалистов. Вот некоторые из них: Чиннатхамби К. «JavaScript с нуля», 2022; Симпсон К. «{Вы пока еще не знаете JS} Познакомьтесь, JavaScript», 2022; Фрисби М. «JavaScript для профессиональных веб-разработчиков», 2022. — Примеч. ред.