В 2006-м психолог по имени Кристина Ольсон начала записывать проявления своеобразной тенденции: дети предпочитают счастливчиков неудачникам[171]. Ольсон и ее коллеги обнаружили такие предпочтения у представителей разных культур в возрасте от трех лет вплоть до вступления во взрослую жизнь[172]. Тезис был справедлив и для тех, кто потерпел мелкие неудачи (например, шлепнулся в грязь), и для тех, кто пострадал от катастроф (например, торнадо). Эффект был стойким и убедительным — истинно положительным.
Затем в 2008 году Ольсон согласилась стать научным руководителем дипломной работы нерадивого 21-летнего студента по имени я[173]. Благодаря ее огромной помощи я придумал скромное дополнительное исследование: будут ли пяти- и восьмилетние дети отдавать больше игрушек счастливчикам, чем неудачникам?
Я опросил 46 детей. Ответ был отрицательным.
Если я и выявил какую-то тенденцию, то она была обратной: мои респонденты, похоже, охотнее делились с несчастными, чем со счастливыми. В отличие от «забавных научных фактов» это казалось очевидным: естественно, вы отдадите игрушку тому, кто ее лишился. Мне нужно было выжать из эксперимента 30 страниц, и я посмотрел на свои данные. Каждый испытуемый ответил мне на восемь вопросов, и я проверил множество условий. В итоге я мог бы разделить результаты на категории несколькими способами.
Здесь, в неброских столбцах чисел, зародилась опасность.
Судя по всему, мой тезис был варваром у ворот. Важное для исходной гипотезы p-значение было значительно выше 0,05[174]. Но, если быть непредвзятым, надо было бы рассмотреть и другие возможные постановки задачи. Что, если я буду рассматривать исключительно пятилетних? Или только восьмилеток? Или только счастливых реципиентов? Или только неудачников? Играет ли значение половая принадлежность? Что, если восьмилетние девочки более отзывчивы по отношению к детям, которым они выставили четверку по шестибалльной шкале приязни, чем пятилетние мальчики?
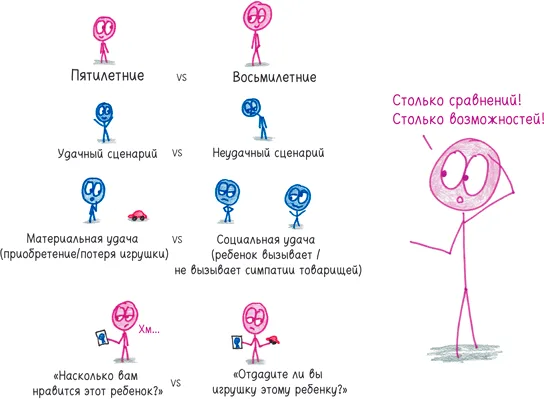
Что, если, что, если, что, если…
По-разному дробя полученные данные, я мог превратить один эксперимент в двадцать. Уже не играло роли, отсеет ли p-значение моего варвара единожды, дважды или десять раз. Я мог маскировать его так или этак, пока он наконец не прокрадется в цитадель.
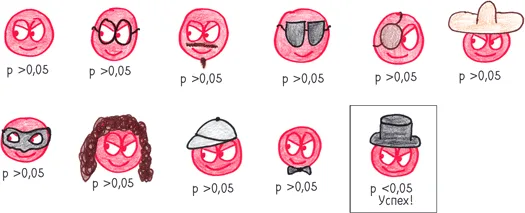
Вот так вот и рождается, возможно, величайший методологический кризис нашего юного столетия: хакерский взлом p-значения. Дайте группе правдолюбивых ученых возможность принять участие в гонке за положительными результатами, где победитель получает все, и наблюдайте, как они, наступая на горло собственной песне, ведут себя как 21-летний я, рационализируя хитроумные решения. «Ну, может, я перепроверю цифры…» «Я же знаю, это правильный результат; просто мне нужно исключить резко выделяющиеся данные…» «О, если я проконтролирую седьмую переменную, p-значение снизится до 0,03…» Большинство исследований носит двусмысленный характер из-за путаницы в переменных и использования множественных способов интерпретации данных. Что вы предпочтете: метод, делающий ваши результаты незначимыми, или тот, который даст p-значение ниже 0,05?
Выловить такого рода чепуху несложно. На сайте Spurious Correlations[175] («Подложные взаимосвязи») Тайлер Виген прочесывает тысячи переменных, чтобы найти пары с тесной, но случайной корреляцией. Например, число утонувших в бассейнах с 1999 по 2009 год шокирующим образом соотносится с количеством фильмов, в которых играет Николас Кейдж.
Засорите фильтр, отсеивающий фантомы, и несколько ложноположительных результатов непременно прокрадутся в цитадель.
Я решил убедиться в этом самостоятельно и разбил 90 респондентов на три группы. Каждый испытуемый выпил или воду из-под крана, или бутилированную воду, или их смесь. Затем я измерил четыре переменные: время бега на стометровку, уровень IQ, рост и любовь к песням Бейонсе. Дальше я провел всевозможные сравнения. Кто пробегает стометровку быстрее: те, кто пил воду из-под крана, или те, кто пил бутилированную воду? Кто больший фанат Бейонсе: те, кто пил бутилированную воду, или те, кто пил смесь? И так далее. Это исследование заняло у меня восемь месяцев.
Да нет, конечно. Я заполнил таблицу с помощью генератора случайных чисел и проделал 50 экспериментов за несколько минут.
Все «респонденты» в принципе не отличались друг от друга: одна и та же программа выдавала произвольные наборы чисел. Все отличия были чисто случайными. Тем не менее три группы и четыре переменные дали 18 «значимых» результатов в 50 экспериментах.
Фантомы, которые впустило p-значение, составили не 1/20, а больше трети.
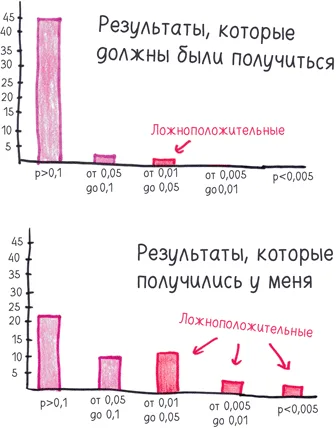
Есть и другие способы взломать p-значение. В 2011 году анонимный опрос психологов показал, что они практикуют «сомнительные исследовательские методы»[176].
Даже самые невинно выглядящие из этих собак могут укусить. Например, сбор дополнительных данных в том случае, если вы не добились желаемого результата с первого раза. Звучит безобидно, правда?
Чтобы оценить силу этого хакерского p-взлома, я смоделировал на компьютере исследование «Кто лучше играет в орлянку?». Проще простого: два «человека» (читай: столбцы чисел) подбрасывают десять монет. Затем мы проверяем, у кого больше решек. Проведя 20 экспериментов, я добился значимого результата один-единственный раз. Вы ожидаете от p-значения именно этого: 20 попыток, один фантом. Сердце бьется ровно.
Затем я пустился во все тяжкие. Подбросьте еще одну монету. И еще одну. И еще одну. Остановите исследование, если p-значение опустится ниже 0,05 (или мы безуспешно подбросим тысячу монет).
Результат преобразился. На сей раз 12 из 20 экспериментов дали значимый результат[177].
Такие фокусы не вполне научны, но это и не бесстыдное мошенничество. Три автора назвали такого рода методы в своей статье «стероидными препаратами научных исследований, которые искусственно повышают эффективность и порождают что-то вроде гонки вооружений, в которой добросовестные исследователи, соблюдающие правила, находятся в невыгодной позиции».
Есть ли способ выровнять игру?